MySQL慢查询分析与索引优化:网站卡成PPT?教你排查慢查询优化索引
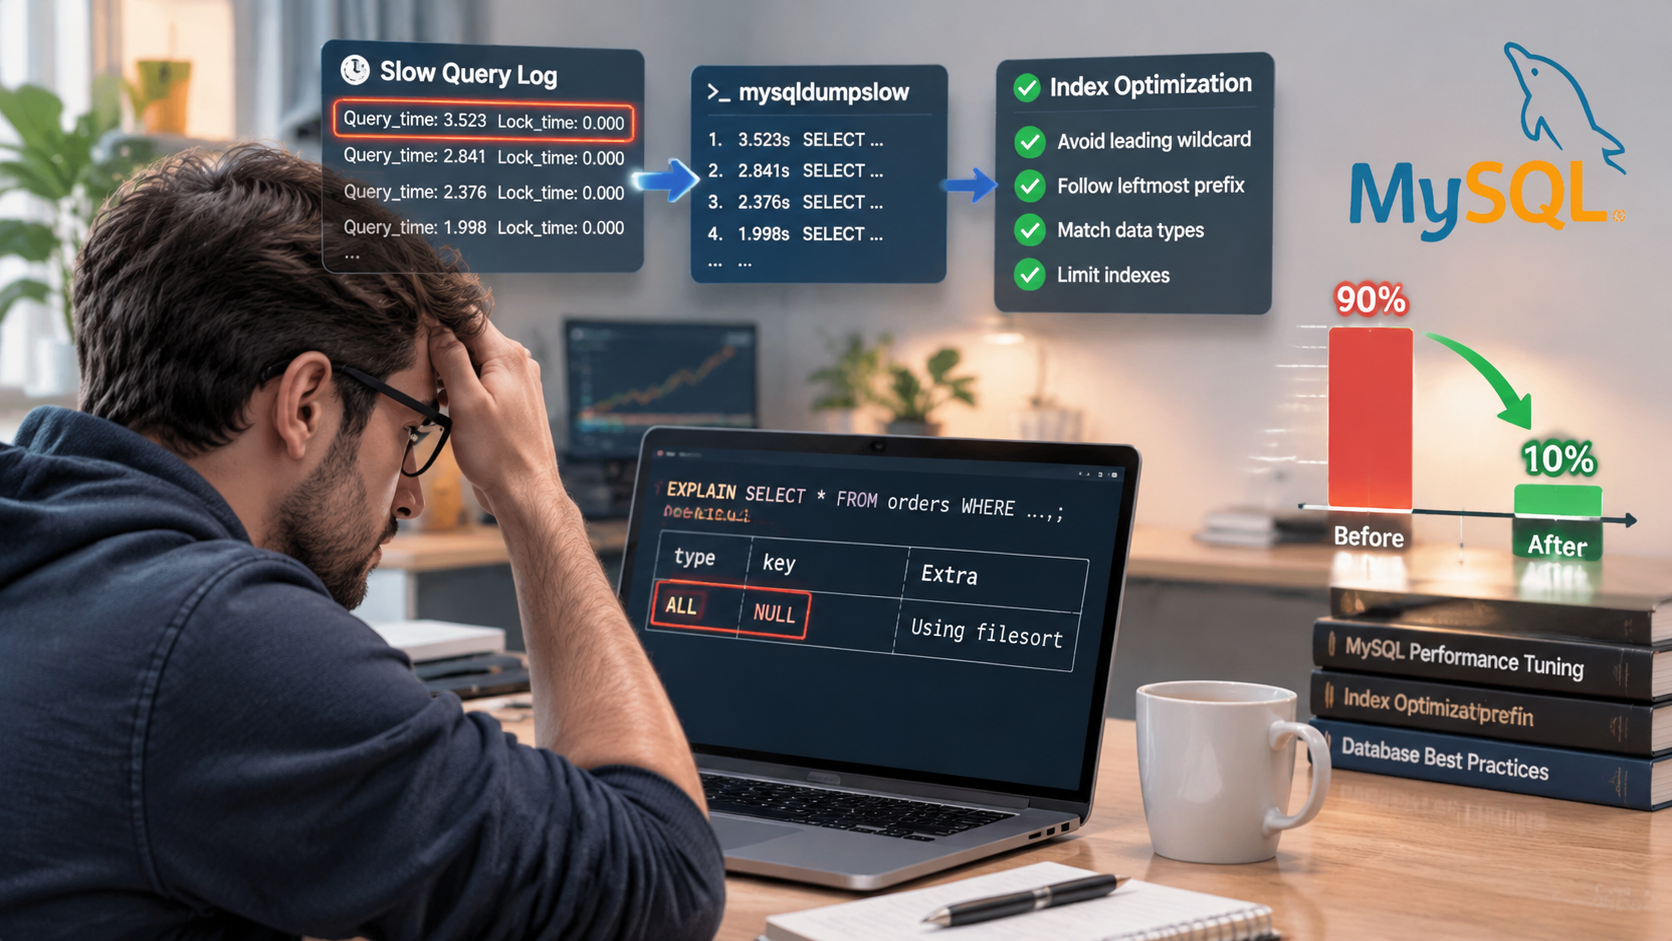
做外贸独立站或者内容站,最怕的就是Google Ads流量刚冲上去,或者Black Friday大促订单一来,网站TTFB(首字节响应时间)直接飙到3秒开外,甚至数据库连接池直接被打爆报502。很多新手站长第一反应是找主机商撕逼或者加钱升配置,但根据我这几年维护几十个WooCommerce和Magento站点的血泪教训来看,80%的性能问题根本不在CPU或者内存,盲目加机器纯属浪费预算。真正搞懂MySQL慢查询分析与索引优化,才是让你的服务器负载从90%暴降到10%的断血式绝招。
今天不扯那些教科书上的数据库底层原理,直接上我平时上机排查的标准化流程和踩坑经验。
第一步:别猜,先把真正的“烂SQL”抓出来
系统卡,千万别凭感觉去猜是哪个插件或哪条查询在作怪。MySQL自带的慢查询日志(Slow Query Log)是唯一的法医级证据。
SSH连上你的Linux服务器,打开MySQL配置文件(一般在 /etc/my.cnf 或 /etc/mysql/mysql.conf.d/mysqld.cnf),在 [mysqld] 模块下加上这几行:
# 开启慢查询日志 slow_query_log = 1 # 日志存放路径,确保mysql用户有写权限 slow_query_log_file = /var/log/mysql/mysql-slow.log # 超过这个执行时间(秒)就记录,外贸站建议设为1秒,并发高的站建议0.5 long_query_time = 1 # 没走索引的查询也给老子记下来(初次排查建议打开,平时可以关掉) log_queries_not_using_indexes = 1改完重启MySQL服务:systemctl restart mysql。
让网站跑个半天一天,慢查询日志里就会积累大量数据。千万不要用 cat 或 vim 直接硬看这个日志,日志文件动辄几百兆,肉眼看能把人看瞎。直接用MySQL自带的分析工具 mysqldumpslow:
# 按总耗费时间排序,显示前10条慢SQL mysqldumpslow -s t -t 10 /var/log/mysql/mysql-slow.log # 按出现次数排序,揪出最频繁拖慢系统的查询 mysqldumpslow -s c -t 10 /var/log/mysql/mysql-slow.log拿到那几条反复出现、耗时又长的SQL语句,我们的靶子就立好了。
第二步:拿 EXPLAIN 照妖镜看它底细
抓到了罪魁祸首,在Navicat、phpMyAdmin或者终端里,在SQL语句前面加上 EXPLAIN 执行一下,看看MySQL到底是怎么执行这条语句的。
你不需要把输出的所有列都背下来,老站长排查问题只死盯这三项:
type(访问类型):- 看到
ALL:赶紧敲警钟,这是全表扫描!意味着你的表哪怕有100万行数据,MySQL也得硬生生从第一行翻到第一百万行。 - 看到
index:全索引扫描,比ALL好一点点,但也极慢。 - 看到
range、ref、eq_ref:这才算及格,说明走到了索引切片。
- 看到
key(实际使用的索引):- 如果显示为
NULL,彻底石锤,这条查询根本没走任何索引。
- 如果显示为
Extra(额外信息):- 如果出现
Using filesort,说明MySQL在拿到数据后还得在内存或磁盘里再排一次序,性能杀手。 - 如果出现
Using temporary,更要命,MySQL为了处理你的查询建了个临时表,高并发下一来直接把I/O拖垮。
- 如果出现
第三步:索引优化,避开这几个致命雷区
知道没走索引或者走得不顺,接下来就是建索引。但建索引不是“哪里报错点哪里”,很多半吊子开发者喜欢把WHERE后面的字段全建一遍单列索引,这完全是帮倒忙。以下是我一线踩过的四个大坑:
1. 模糊查询把通配符放前面
很多人做站内产品搜索,SQL直接写成:
SELECT * FROM wp_posts WHERE post_title LIKE '%iPhone%';只要开头带了 %,无论你给 post_title 建了多完美的索引,直接失效。因为B+树索引是按从左往右排序的,前缀都不知道是啥,MySQL只能去全表扫描。 解决办法:这种需求量大的站内搜索,数据量小就改成 LIKE 'iPhone%';数据量几万几十万往上走,老老实实上全文索引(FULLTEXT)或者直接挂Elasticsearch/Meilisearch,别难为MySQL。
2. 最左前缀原则翻车(复合索引)
假设我们经常要查某个买家在特定状态下的订单,建了个复合索引:(user_id, order_status, created_at)。
- 查
WHERE user_id = 123 AND order_status = 'completed'-> 正常走索引。 - 查
WHERE order_status = 'completed'-> 索引完全不生效,因为跳过了最左边的user_id。 记住:复合索引就像用“姓+名”查电话薄,你不知道别人姓什么,只知道叫“强”,这电话薄你只能从头翻到尾。
3. 字段类型隐式转换
这是最隐蔽的坑!举个真实案例:用户的手机号或订单号字段 order_sn,建表时设的是字符串类型 varchar(32)。 但在业务代码里,很多程序员图省事直接传了数字进去:
SELECT * FROM orders WHERE order_sn = 202311050001;看似没毛病,但在底层,MySQL为了做比对,会对整张表的每一行数据调用转换函数把字符串转成数字再比对。索引瞬间报废,全表扫描。必须在代码层面强制加上引号,保证数据类型一致:
SELECT * FROM orders WHERE order_sn = '202311050001';4. 不要建一堆垃圾单列索引
单表索引千万别超过5到6个。每次你在页面上做一次加购、更新订单、甚至修改文章,MySQL除了写数据,还要同步维护你建的那些B+树索引文件。 索引不是越多越好,它本质上就是拿磁盘空间和写入性能去换读取速度。对于读多写少的外贸展示站可以适当放宽,对于订单写入频繁的站,冗余索引就是压垮服务器的最后一根稻草。
运维老鸟的收尾建议
把慢查询抓出来、EXPLAIN分析明白、索引给加到位之后,通常你的网站响应速度就会肉眼可见地恢复顺滑。
但搞完这些,记得回头把生产环境配置文件里的 log_queries_not_using_indexes 关掉,把 long_query_time 提到一个合理值(比如1-2秒),否则慢日志文件一天就能吃掉你好几个G的磁盘空间。日常运维中,定期拉一下慢查询报告,配合系统监控看看iowait和CPU使用率,基本就能保证你的独立站在流量高峰期稳如老狗。先从最慢的那条SQL改起,别指望一口吃成胖子。