Linux服务器CPU爆满排查实战:服务器CPU干到100%怎么查
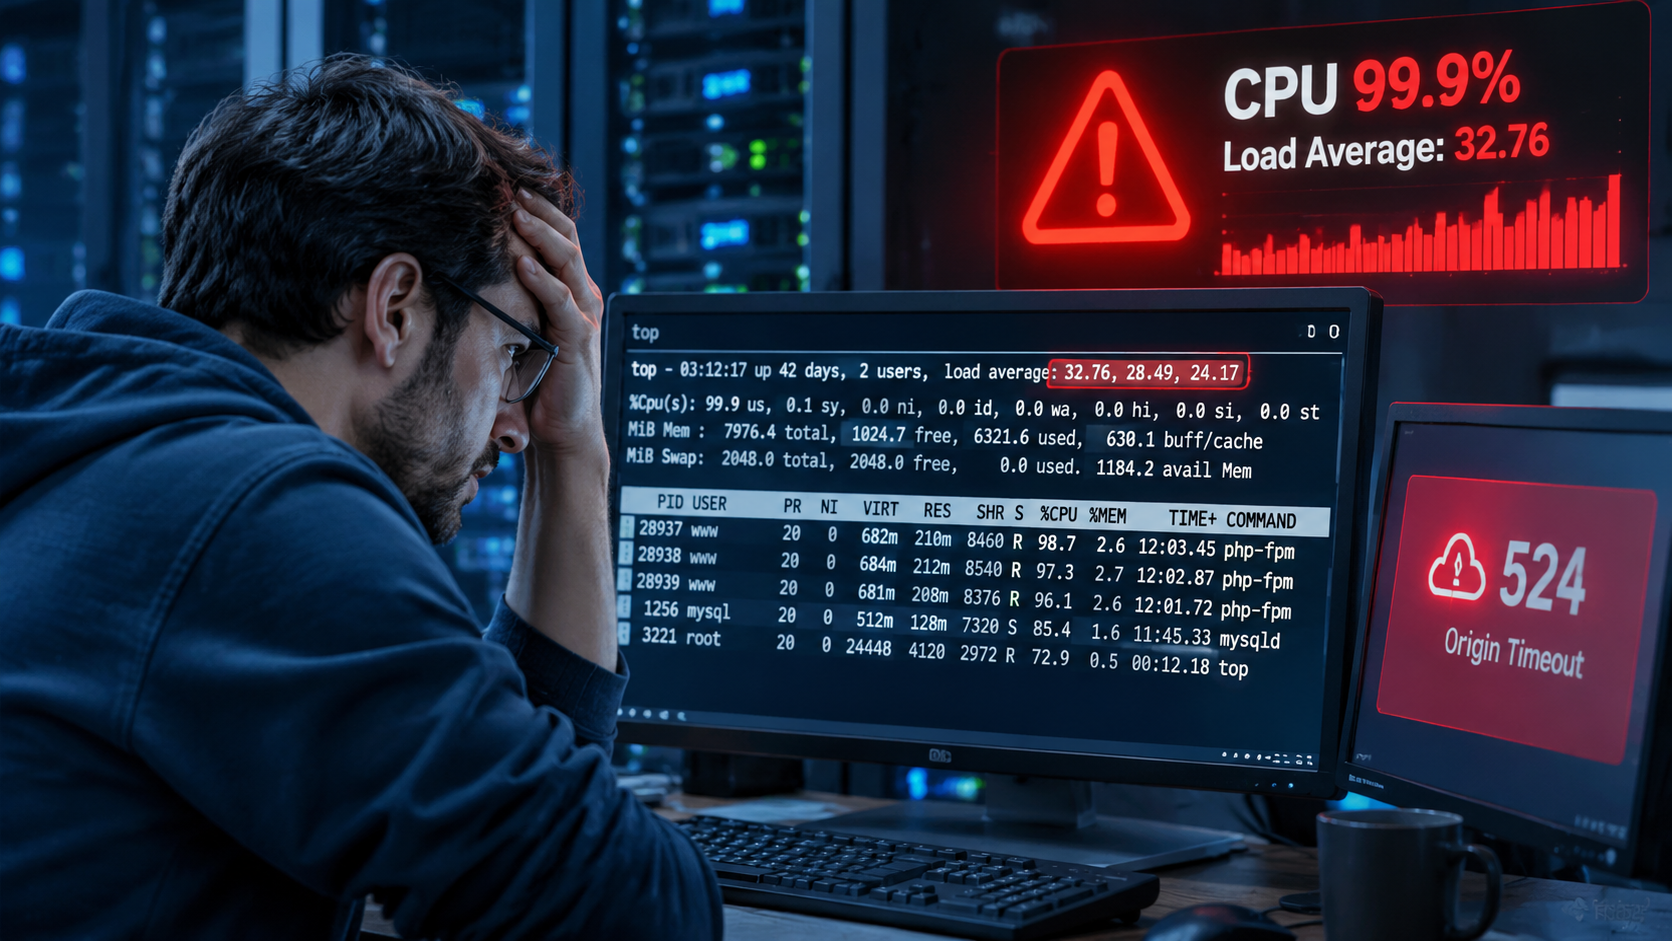
凌晨两三点,手机突然疯狂弹监控告警,打开一看:Load Average飙到几十,CPU利用率99.9%,网站打不开,Cloudflare直接给你报524超时——这场景每个做独立站的运维和老站长应该都不陌生。很多新手第一反应是直接进后台点“Reboot”,运气好能顶半小时,运气不好开机瞬间CPU继续拉满。重启解决不了根本问题,今天这篇Linux服务器CPU爆满排查实战,我就按平时自己处理线上故障的排查链路,带大家顺藤摸瓜,把那些吃光算力的“元凶”揪出来弄死。
第一步:别急着杀进程,先看看到底谁在作妖
登进终端第一件事,永远是敲 top。
top敲完之后,眼睛别乱瞅,重点看这几个核心指标:
- 右上角 Load Average:三个数值分别代表过去1分钟、5分钟、15分钟的系统负载。如果你的VPS是4核,Load跑到了8甚至10以上,说明任务排队已经堵死。
%Cpu(s)这一行:- us (user):用户空间占用高。八成是你的应用(Nginx、PHP-FPM、MySQL、Node.js)被大流量冲了,或者代码在死循环。
- sy (system):内核空间占用高。进程在频繁进行系统调用,或者有严重的上下文切换。
- wa (iowait):这个极度致命! 很多人以为wa高是CPU不行,其实是磁盘IO跟不上了(机械盘或者垃圾云厂商的超卖SSD)。CPU全在干等着硬盘读写,导致任务堆积。
- 按一下键盘大写的
P:让进程列表直接按CPU使用率降序排列。排在最前头的那几个PID,就是你的首要嫌疑犯。
第二步:对号入座,三大经典“背锅侠”排查
在外贸建站和内容站的运维环境里,CPU爆满90%脱离不开以下三种情况。
1. PHP-FPM / Python / Node 进程把资源榨干
做WordPress或者独立站商城最容易遇到这事。满屏幕都是 php-fpm: pool www,单个进程吃你30%~50%,十几个进程直接吃满。
顺藤摸瓜: 拿到了高占用的 PID,先别急着 kill -9,查查它在干什么:
# 查看这个进程具体在跑什么脚本或打开了什么文件 lsof -p # 实时追踪这个进程在干啥系统调用(如果刷屏很快,说明在疯狂死循环读写) strace -p -s 100 如果定位到是正常访客搞出来的,立刻查Web访问日志。拿 Nginx 举例,看看是不是有爬虫在疯狂抓取你的动态页面:
# 统计当前访问量最高的20个IP tail -n 10000 /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -nr | head -20很多垃圾SEO工具(比如Semrush、Ahrefs或者国内某些乱七八糟的爬虫),根本不遵守 robots.txt,一秒钟扫你几十个带搜索参数的动态URL,没做页面缓存的站点瞬间就能被干趴下。
2. MySQL (mysqld) 疯狂占用
如果排第一的是 mysqld,证明数据库成了瓶颈。有可能是慢查询导致的,也可能是锁表了。
处理办法: 连进数据库直接看现场:
-- 登录 MySQL 后执行 SHOW FULL PROCESSLIST;重点看 Time(执行秒数)很长、State 显示为 Copying to tmp table、Sorting result 或者 Locked 的语句。 把那条又臭又长、拖慢全局的查询抓出来,先临时干掉救场:
KILL ; 之后老老实实去排查网站插件:是不是用了烂大街的站内实时搜索?是不是某些统计插件在每一页都往数据库硬写日志?赶紧上 Redis 缓存对象,把慢查询日志(Slow Query Log)打开优化索引。
3. 最恶心的情况:中了挖矿木马(XMRig等)
很多站长为了省事,SSH用弱密码,或者WordPress插件常年不更新被爆了RCE漏洞,机器沦为肉鸡。
挖矿病毒的典型特征:
- CPU干到 99% 或 100%。
- 进程名字看着很像系统核心进程,比如
kworker/0:1、sysupdate、systemd-daemon。 - 你一敲
top,占用率瞬间降下来(病毒自带防检测逻辑),关掉终端它又拉满。
排查手段: 看看恶意进程的网络连接:
# 查看对外建立的连接,很多矿机都会连矿池的特定端口 ss -antp | grep ESTABLISHED查看恶意定时任务(病毒最喜欢在这里留后手):
crontab -l cat /etc/crontab ls -al /etc/cron.* cat /var/spool/cron/crontabs/* 2>/dev/null如果找到了挖矿进程的绝对路径(一般在 /tmp、/dev/shm 或者 /var/tmp),先别光删文件,必须连带把Cron、自启服务和SSH的 authorized_keys 全盘清洗,否则一分钟内原地复活。
第三步:快速止血与长期防爆建议
排查出问题只是治标,真要让外贸站安安稳稳跑着,日常架构就得做好冗余和限流。
1. 紧急止血方案
- 遇到恶性爬虫:直接在 Nginx 层面封禁对应 User-Agent 或 IP。
if ($http_user_agent ~* (SemrushBot|AhrefsBot|Bytespider)) { return 403; }如果套了 Cloudflare,直接去后台 WAF 规则里开“Under Attack”模式,或者针对恶意地区和ASN打人机验证(Managed Challenge)。
- 遇到PHP并发打满:改
php-fpm.conf。把pm = dynamic换成更激进的pm = ondemand,或者调小pm.max_children,宁可让访客稍微排队,也别让进程把服务器内存和CPU活活挤爆导致整机宕机。
2. 长期防御策略
- 页面静态化和动态缓存:做外贸内容站、B2B展示站,Nginx FastCGI Cache 或 Redis 页面缓存是标配,95%的请求根本不应该落到 PHP 和 MySQL 上。
- 限制后台进程资源:用
systemd的资源控制功能,给 MySQL、PHP 进程限制最大 CPU 配额(CPUQuota=80%),留出 20% 的算力保证你 SSH 还能连得上去排查,不至于失联只能硬重启。 - 砍掉非必要插件:WordPress 里的备份插件、安全扫描插件,千万别设在白天高流量时段跑,统统改到访客最少的后半夜去执行。
线上维护没有玄学,CPU满载一定是某行代码、某个查询或某个请求在硬耗资源。按上面的步骤逐步缩小包围圈,你也能在十分钟内从容摘掉系统隐患。